 Autor: Kamil Kosiorek „Kosior” — właściciel Vis-Sol, autor i właściciel procesu
Case study / procesy serwerowe
Przetwarzanie jednego elementu trwało od 5 do 10 minut. Ponieważ wszystkie zadania przechodziły przez wspólną kolejkę sekwencyjną, krótkie operacje czekały na pracę, od której w rzeczywistości nie zależały.
krótszy czas wykonania analizowanego zestawu zadań po zmianie architektury kolejki
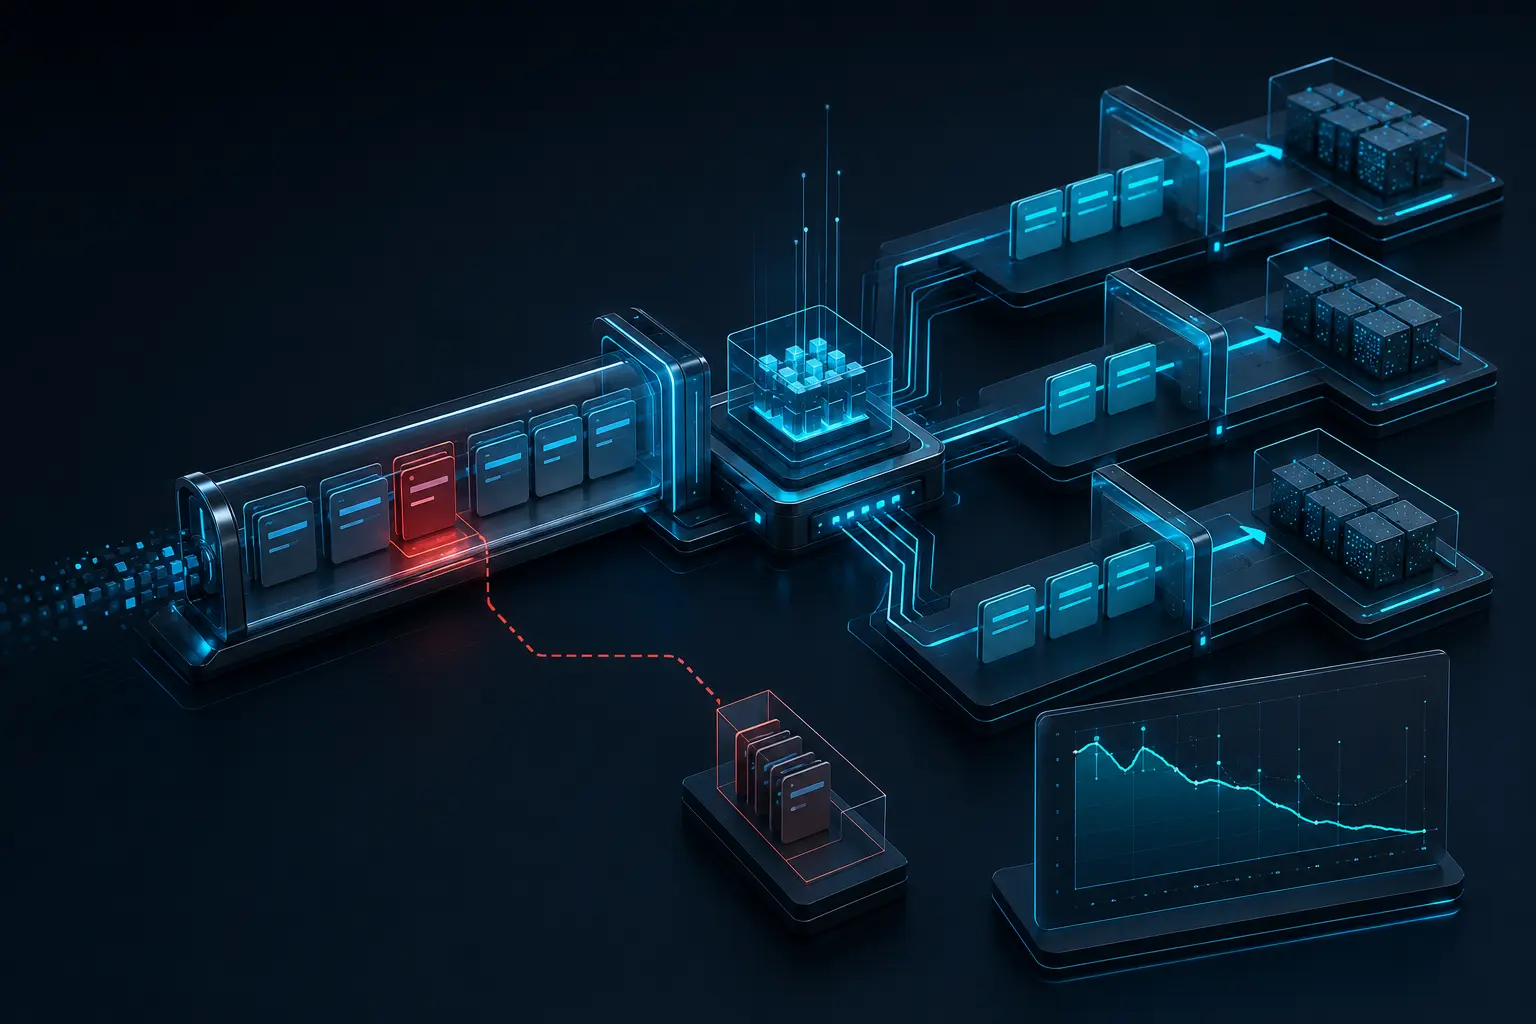
Zmiana modelu Wspólna kolejka → kontrolowane przepływy
Dlaczego jedno długie zadanie blokuje cały proces?
Długie zadanie blokuje cały proces, gdy operacje niezależne trafiają do jednej kolejki i są wykonywane sekwencyjnie. Wtedy kolejność techniczna udaje zależność biznesową. Rozwiązaniem jest klasyfikacja zadań, wydzielenie pracy w tle, zachowanie zależności tylko tam, gdzie są rzeczywiste, oraz pomiar czasu przed zmianą i po niej.
Pytania o kolejki i procesy asynchroniczne
Jak rozdzielić zadania zależne i niezależne?
Każdy etap powinien deklarować, jakiego wyniku naprawdę potrzebuje. Operacje bez takiej zależności mogą działać w osobnym przepływie, z własnym statusem, limitem czasu i obsługą ponowienia.
Jak automatyzować długotrwałe zadania?
Należy przenieść je poza ścieżkę interaktywną, rejestrować stan, zapewnić idempotencję i bezpieczne ponowienie. Użytkownik powinien otrzymać status zamiast utrzymywać otwarte żądanie przez kilka minut.
Jak ograniczyć koszty infrastruktury bez utraty stabilności?
Najpierw usuwa się sztuczne blokady i niepotrzebną równoległość. Dopiero pomiar kolejki, czasu CPU, pamięci i liczby ponowień pokazuje, czy potrzebna jest większa infrastruktura.
Stan początkowy
System wykonywał zadania w kolejności dodania. Część operacji obejmowała analizę lub przygotowanie danych trwające 5–10 minut. W tym czasie kolejne zadania pozostawały w oczekiwaniu, mimo że nie potrzebowały wyniku długiego procesu.
zajmuje wspólnego wykonawcę przez kilka minut
pozostają w kolejce bez technicznej zależności
czas całego zestawu zależy od najwolniejszego elementu
Diagnoza
Problemem nie był wyłącznie czas samego przetwarzania. Kluczowe było to, że architektura traktowała wszystkie zadania tak samo. Kolejność techniczna zaczęła udawać zależność biznesową.
Decyzja
Oddzieliliśmy zadania interaktywne i krótkie od procesów długotrwałych. Długi proces otrzymał własny tryb wykonania w tle, status i możliwość bezpiecznego ponowienia. Zależności pozostały tylko tam, gdzie kolejny etap rzeczywiście wymagał wyniku poprzedniego.
zadanie krótkie, długie albo naprawdę zależne
długa praca wykonuje się w tle i raportuje stan
limity, ponowienia, idempotencja i obsługa błędów
porównanie tego samego zestawu przed i po zmianie
Rezultat
W analizowanym zestawie czas realizacji całego zadania spadł o około 45%. Wynik nie oznacza, że każda kolejka przyspieszy dokładnie o tę wartość. Zależy od udziału zadań długich, rzeczywistych zależności, zasobów serwera i sposobu obsługi błędów.
Kiedy ten wzorzec ma sens
- generowanie raportów, eksportów i plików;
- analiza dokumentów lub większych zbiorów danych;
- synchronizacja z zewnętrznym systemem;
- zadania AI, których wynik nie jest potrzebny natychmiast;
- operacje okresowe konkurujące z obsługą użytkownika.
Uczciwy zakres wyniku
45% dotyczy tego przypadku
To wynik porównania analizowanego zestawu zadań, a nie obietnica dla każdego systemu.
PID-y, workery i watchdog
Ciągłość procesów na hostingu
Technologia VSA
Masz podobny proces?
Opisz, co czeka i od czego naprawdę zależy.
Wstępnie wskażemy, czy problem może wynikać z kolejki lub synchronizacji. Analiza kodu, logów i infrastruktury jest osobnym zakresem.
Zobacz też: Automatyzacja procesów w firmie · Integracja systemów i API