 Autor: Kamil Kosiorek „Kosior” — właściciel Vis-Sol, autor i właściciel procesu
Case study / ciągłość usługi
Ograniczenia środowiska okresowo kończyły procesy działające przez dłuższy czas. Zamiast udawać, że restartów nie będzie, zastąpiliśmy niekontrolowane przerwania kontrolowanym cyklem technicznym, checkpointami i nadzorem.
model dostępności usługi z kontrolowanym zdarzeniem technicznym zamiast przypadkowych wyłączeń
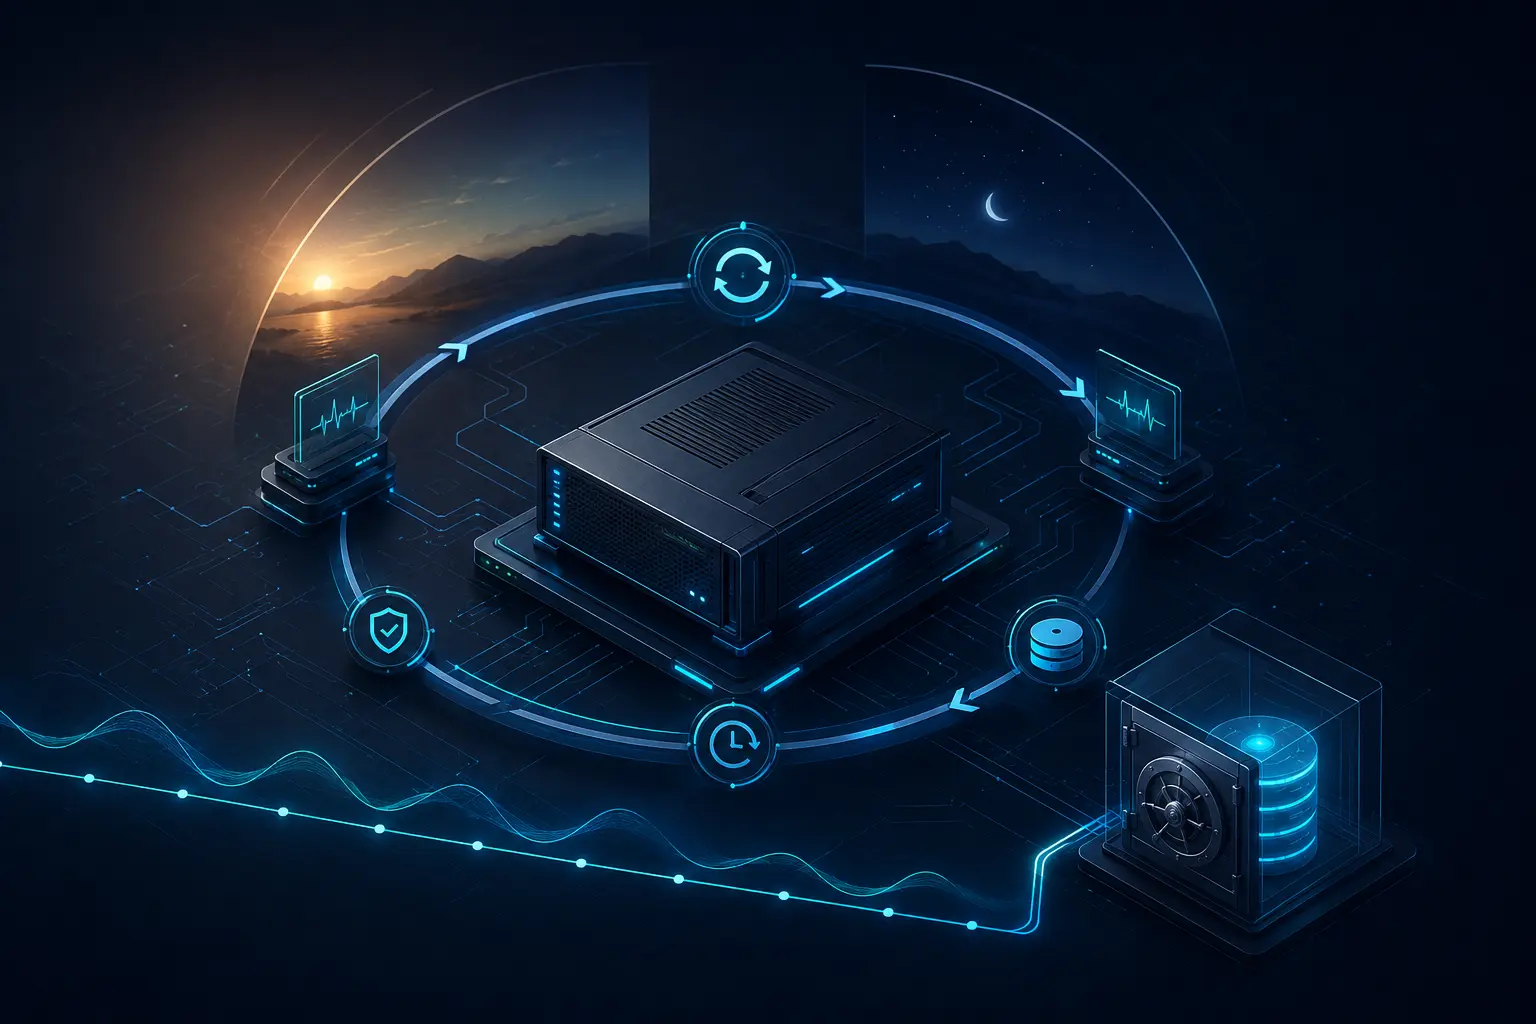
Stabilizacja Checkpoint → cykl → kontrola → wznowienie
Jak prowadzić długie procesy na hostingu współdzielonym?
Długie procesy na hostingu współdzielonym powinny działać w kontrolowanych odcinkach, zapisywać checkpointy i umożliwiać bezpieczne wznowienie. Zamiast liczyć na nieograniczony czas wykonania, projektuje się przewidywalny cykl techniczny, częściową kopię stanu i proces nadzorczy. Jeżeli wymagania przekraczają granice środowiska, potrzebna jest migracja.
Pytania o ciągłość działania na ograniczonym serwerze
Jak wznowić przerwany proces bez utraty danych?
Proces zapisuje minimalny, spójny checkpoint oraz identyfikator ostatniego poprawnie zakończonego etapu. Po ponownym uruchomieniu sprawdza stan i kontynuuje bez powtarzania operacji, które mogłyby zostać zdublowane.
Czy automatyczny restart wystarczy?
Nie zawsze. Bez checkpointu i kontroli idempotencji restart może rozpocząć pracę od początku, powtórzyć zapis albo odtworzyć niespójny stan. Potrzebna jest również weryfikacja, czy usługa faktycznie wróciła do zdrowia.
Kiedy hosting współdzielony przestaje wystarczać?
Gdy proces wymaga ciągłego wykonania, dużej pamięci, własnego menedżera procesów, intensywnej kolejki lub gwarantowanych parametrów. Kontrolowane cykle nie powinny maskować trwałego niedopasowania infrastruktury.
Stan początkowy
Usługa wykonywała procesy długotrwałe w środowisku współdzielonym. Hosting okresowo kończył proces po przekroczeniu własnych ograniczeń. Przerwanie mogło wystąpić w ciągu dnia, bez pewności, który etap był ostatnim poprawnie zapisanym.
Dlaczego zwykłe automatyczne uruchomienie nie wystarczyło
Sam restart procesu mógł uruchomić pracę ponownie od początku, zdublować operację albo odtworzyć niepełny stan. Potrzebny był kontrolowany punkt zatrzymania, zapis informacji koniecznych do wznowienia oraz mechanizm sprawdzający, czy usługa faktycznie wróciła.
zapis minimalnego, spójnego stanu potrzebnego do kontynuacji
ochrona bieżących, najważniejszych treści i konfiguracji
planowane odświeżenie mniej więcej co 12 godzin, głównie w porze nocnej
kontrola stanu, automatyczne uruchomienie i weryfikacja zdrowia
Decyzja
Nie walczyliśmy z charakterem hostingu współdzielonego przez dokładanie kolejnych ciężkich procesów. Wdrożyliśmy przewidywalny cykl techniczny. Przed nim stan był porządkowany i zapisywany, a po uruchomieniu mechanizmy nadzorcze sprawdzały działanie oraz możliwość kontynuacji.
Rezultat
Przypadkowe wyłączenia w ciągu dnia przestały być głównym modelem działania. Serwis pracuje w modelu 24/7, z kontrolowanym zdarzeniem technicznym w zaplanowanym oknie. Nie oznacza to obietnicy absolutnego braku restartów — oznacza zastąpienie nieprzewidywalnego zatrzymania zdarzeniem zaplanowanym i nadzorowanym.
Kiedy zastosować podobny model
- zadania długotrwałe na hostingu z limitami czasu i pamięci;
- procesy, które mogą bezpiecznie kontynuować pracę od checkpointu;
- usługi bez budżetu na natychmiastową migrację do osobnej infrastruktury;
- cykliczne synchronizacje, importy, eksporty i przetwarzanie plików.
Kiedy potrzebna jest migracja
Jeżeli proces wymaga ciągłego wykonania bez przerw, dużej pamięci, własnego menedżera procesów, intensywnej kolejki lub gwarantowanych parametrów, hosting współdzielony może przestać być właściwym środowiskiem. Kontrolowany cykl nie powinien maskować trwałego niedopasowania infrastruktury.
Kontrolowany restart to nie brak restartów
Celem było zastąpienie nieprzewidywalnych wyłączeń bezpiecznym i nadzorowanym cyklem.
PID-y, workery i watchdog
Kolejka i latencja
Błąd po aktualizacji
Masz podobny problem?
Podaj hosting, typ procesu i moment wyłączenia.
Wstępnie ocenimy, czy potrzebny jest checkpoint, nadzór, zmiana architektury czy migracja. Dostęp do serwera i wdrożenie są osobnym zakresem.
Zobacz też: Integracja systemów i API · Automatyzacja procesów w firmie