 Autor: Kamil Kosiorek „Kosior” — właściciel Vis-Sol, autor i właściciel procesu
Case study / Linux · procesy · hosting współdzielony
Każdy mechanizm z osobna działał logicznie. Problem pojawił się wtedy, gdy worker, cron, watchdog, supervisor i orchestrator zaczęły niezależnie zarządzać tym samym lifecycle. Efekt: lawinowy wzrost PID-ów, skok RAM i ryzyko wpływu na inne usługi.
100 → 48
aktywnych procesów po uporządkowaniu warstwy wykonawczej; około 52% mniej względem stanu przed optymalizacją
szczyt ≈360 PID
>2,6 GB RAM
jeden lifecycle na rolę
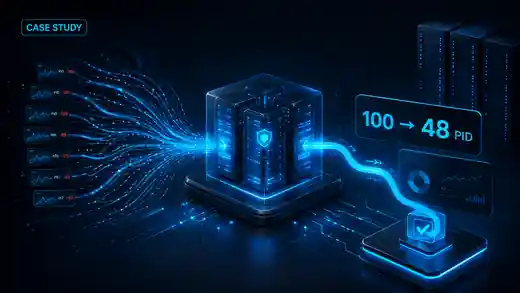
Case study Vis-Sol 100 → 48 PID · kontrolowany lifecycle i monitoring
Dlaczego liczba PID-ów potrafi rosnąć mimo poprawnie działających workerów?
Bo kilka poprawnych mechanizmów może niezależnie zarządzać tą samą rolą. Cron, watchdog, supervisor i własny cykl workera mogą uruchamiać kolejne instancje bez wspólnego modelu ownership.
Problemem nie był jeden worker. Problemem był brak jednego modelu własności procesu.
W środowisku działało kilka niezależnych mechanizmów wykonawczych. Część workerów miała własny cykl pracy, inne zadania uruchamiał cron, watchdog reagował na stan usług, supervisor utrzymywał procesy, a orchestrator startował kolejne elementy systemu.
Każdy mechanizm był uzasadniony osobno. Dopiero widok całego środowiska pokazał, że podobna funkcja mogła zostać uruchomiona więcej niż jeden raz. Jeśli poprzednia instancja nie kończyła pracy przed kolejnym wywołaniem, pojawiała się następna; procesy potomne dodatkowo przyspieszały wzrost liczby PID-ów.
Nowy proces według zegara
harmonogram nie wiedział, czy poprzednia instancja nadal pracuje
Restart na podstawie sygnału
brak sygnału mógł zostać odczytany jako brak procesu
Własny cykl i potomkowie
długotrwała praca mogła tworzyć dodatkowe procesy pomocnicze
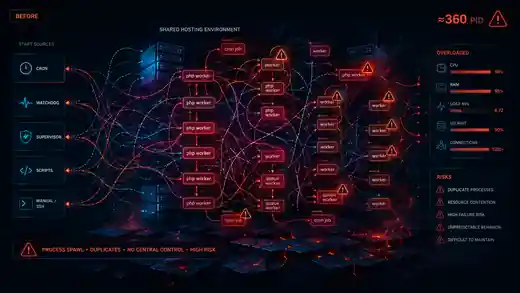
Przed optymalizacją. Cron, watchdog, supervisor, skrypty i uruchomienia ręczne tworzyły nakładające się ścieżki startu i restartu.
Sam PID nie wystarcza
Numer procesu potwierdza istnienie wpisu w tablicy procesów, ale nie opisuje roli, zdrowia ani właściciela lifecycle. Przed restartem trzeba potwierdzić tożsamość procesu, stan healthcheck, drzewo potomków i mechanizm, który ma prawo nim zarządzać.
Decyzja architektoniczna: 1 rola = 1 właściciel procesu = 1 sposób uruchamiania
Przed dołożeniem nowego workera sprawdzamy, czy funkcja już istnieje. Jeśli istnieje, aktualizujemy bieżący mechanizm albo zastępujemy go nowym. Nie uruchamiamy nowej wersji obok starej tylko dlatego, że poprzednia „prawdopodobnie” już nie działa.
Kolejka albo jawna równoległość
Jeśli dwa zadania nie powinny wykonywać się równolegle, trafiają do wspólnej kolejki. Jeżeli równoległość jest potrzebna, staje się częścią architektury: każda domena otrzymuje własnego workera, odpowiedzialność i jawny budżet procesów.
punkt kontroli i ownership
MLP / SEMANTIC
oddzielone domeny obliczeń
własna kolejka pracy
nadzór bez multiplikacji
Worker zamiast crona dla częstych cykli
Dla często wykonywanych zadań lepszym modelem jest jeden długotrwały worker z własnym cyklem: wykonanie → oczekiwanie → kolejne wykonanie → healthcheck. Cron pozostaje dla zadań faktycznie okresowych, np. backupu, housekeeping, raportu dziennego albo audytu.
Watchdog diagnozuje przed restartem
Brak oczekiwanego sygnału nie musi oznaczać, że proces nie istnieje. Kontrola przed restartem obejmuje proces główny, procesy potomne, healthcheck, właściciela usługi i możliwość równoległego nadzoru przez inny mechanizm.
czy proces naprawdę nie istnieje
czy zostały procesy potomne
czy proces jest zawieszony
OWNER → RESTART
restart dopiero po wykluczeniu duplikatu
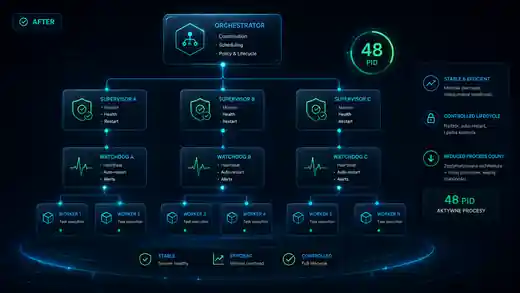
Po optymalizacji. Jeden model ownership, jawny lifecycle, kontrolowany health i przewidywalny budżet procesów.
Rezultat: mniej procesów było skutkiem, przewidywalność była celem
Po uporządkowaniu workerów, źródeł startu i nadzoru liczba aktywnych procesów spadła z około 100 do 48. Jednocześnie ograniczono warunki, które wcześniej pozwalały środowisku eskalować do setek PID-ów. Sama redukcja nie jest uniwersalnym benchmarkiem — dotyczy konkretnego środowiska i incydentu.
Blast radius na hostingu współdzielonym
Gdy kilka projektów korzysta ze wspólnego budżetu zasobów, wzrost liczby procesów lub pamięci w jednej aplikacji może ograniczyć pozostałe usługi. Dlatego monitoring powinien obejmować całe konto: PID-y użytkownika, RAM, drzewa procesów, aktywne harmonogramy i mechanizmy nadzoru.
Sugestie operatorskie — najpierw obserwacja, potem zmiana
Komendy poniżej skracają diagnostykę i ułatwiają zachowanie kolejności pracy. Najpierw zapisujesz baseline, następnie wykonujesz jedną zmianę i ponownie sprawdzasz PID, RAM oraz health.
1. Liczba procesów użytkownika
ps -u "$USER" -o pid= | wc -l
Ustal punkt odniesienia przed zmianą.
2. Największe procesy według RAM
ps -u "$USER" -o pid,ppid,rss,%mem,cmd --sort=-rss | head -n 25
Oddziel samą liczbę PID od realnego kosztu pamięci.
3. Duplikaty ról
pgrep -af 'worker|orchestrator|watchdog|supervisor'
Sprawdź, czy kilka mechanizmów nie uruchamia podobnej funkcji.
4. Drzewo rodzic → dzieci
pstree -ap "$USER"
Przed restartem sprawdź procesy potomne.
Sześć reguł projektu
- Najpierw sprawdź, czy rola już istnieje.
- Jeden worker — jeden właściciel lifecycle.
- Równoległość projektuj jawnie.
- Cron nie jest supervisorem.
- Watchdog diagnozuje przed restartem.
- Monitoruj środowisko, nie tylko pojedynczą usługę.
Masz podobny problem?
Przeanalizujemy procesy, PID-y i mechanizmy nadzoru.
Bez dokładania kolejnej warstwy na ślepo — najpierw diagnoza, potem uporządkowanie ownership i lifecycle.
FAQ
Nie. PID potwierdza istnienie procesu, ale nie opisuje roli, zdrowia ani właściciela lifecycle.
Zwykle nie. Długotrwały worker powinien mieć jeden jawny mechanizm uruchamiania i nadzoru.
Jeśli restartuje usługę bez sprawdzenia procesu, potomków i ownership, może utworzyć duplikat.
Nie. Równoległość jest poprawna, jeśli liczba instancji, kolejki, ownership i budżet zasobów są jawnie kontrolowane.
100 → 48 dotyczy tego środowiska
Najważniejszy wynik to kontrolowany ownership i przewidywalny budżet procesów.
Kolejka i latencja
Ciągłość procesów na hostingu
Wszystkie case studies
Masz podobny proces?
Najpierw policz procesy i ustal ownership.
Możemy przeanalizować lifecycle workerów, cron, watchdog, supervisor i wpływ warstwy wykonawczej na budżet hostingu.
Zobacz też: Integracja systemów i API · Automatyzacja procesów w firmie